被测对象:一场四面有墙的五人制足球
模拟示例:玩家在乐鱼体育输入“室内五人制足球,四面墙反弹有效,6分钟一场,平局点球决胜”。生成系统交出了第一个版本V1:28米乘15米的室内场地、四面围墙、两个球门、每队4名外场球员加1名门将、6分钟计时、平局进入点球。
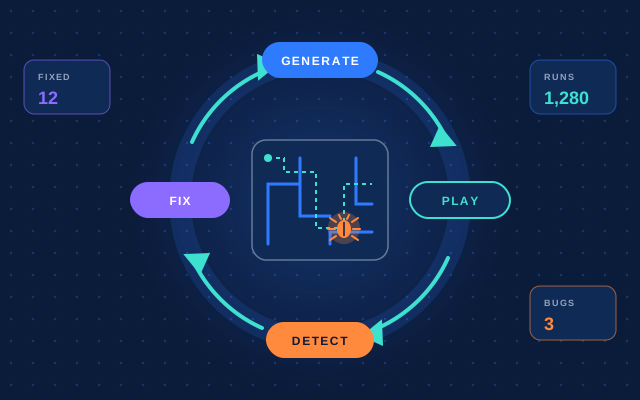
配置上它什么都不缺。但测试Agent的任务不是看配置,而是用和玩家一样的输入接口上场,按下面的闭环走:
Simulate:派三种不同的Agent上场
只用一种Agent测试,会漏掉大量问题。一个会踢球的Agent永远不会把球踢进墙角,一个乱跑的Agent则永远走不到比赛结束。示例里同时派出三类:
- 探索型Agent:接近随机地移动、踢球、撞墙,专门覆盖正常玩家不会去的角落。
- 规则型Agent:按脚本完成开球、传球、射门、进球,验证目标能不能完成、比分能不能累加、比赛能不能结束。
- 模仿型Agent:按不同水平的玩家行为模型操作,用来评估AI对手的表现和难度。
这不是新思路。公开资料显示,King在2018年的论文里用玩家数据训练模型模仿“最像人类”的操作来预测关卡难度;EA SEED在2020年的论文里用深度强化学习提高测试覆盖率,寻找漏洞和地图问题。区别在于,生成式系统里每个作品都是新的,测试必须在生成后自动发生,而不是等测试团队排期。
Detect:八类检查项,各自靠什么信号发现
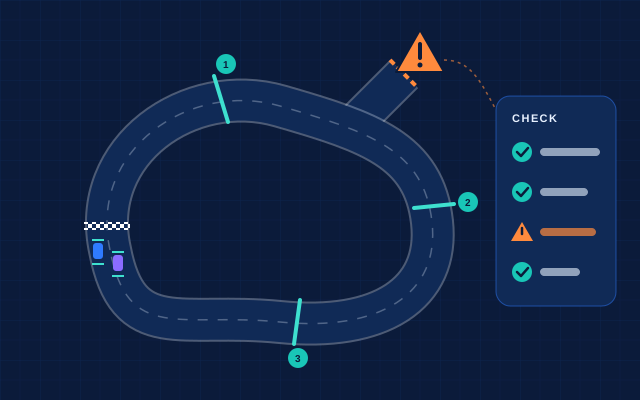
第一轮200场模拟比赛(模拟数据)跑完后,检测器读取每场的事件日志和状态记录,按八类检查逐项判断:
| 检查项 | 判断信号 | V1中发现的问题 |
|---|---|---|
| 出生点进入 | 开局5秒内角色能否移动 | 蓝队门将出生在球网碰撞体内,无法移动 |
| 完成目标 | 规则型Agent能否完成进球 | 能完成,但见下一项 |
| 得分 | 球越线与比分变化是否一致 | 进球触发器离门线太深,球打到后网弹出时未计分 |
| 比赛结束 | 每场是否到达结算状态 | 平局场次卡在点球阶段 |
| 地图死路 | 球或球员长时间停在同一位置 | 右下角墙面与门柱之间有夹角,球卡住不动 |
| 规则冲突 | 出现没有规则处理的状态 | 高球飞过墙顶,没有出界规则接手 |
| AI行为 | AI站位与跑动分布 | AI外场球员全部追球,后场无人 |
| 难度 | 不同水平模仿Agent的胜负分布 | 新手水平Agent平均净负7球以上 |
有两项值得单独说。
“比赛结束”的问题来自规则和地图之间的缺口:规则写了平局点球,但空间模型没有生成点球点,也没有定义点球时其他球员站在哪里。比赛状态机进入点球阶段后找不到开始条件,只能一直等待。这类问题静态检查也许能发现,但让Agent实际打到平局,一定能发现。
“规则冲突”则是一个典型的组合问题。“四面墙反弹有效”让系统默认不需要边线球和球门球,但墙有高度,场馆没有屋顶,一脚大力高球就能飞出场外。此时既没有出界规则,也没有重新开球的位置,球消失了,计时还在走。
Modify:问题要退回到具体模块,而不是整体重生成
最差的做法是把整场比赛重新生成一次,修好旧问题又带来新问题。更好的做法是把每一项定位到负责的模块,只改那一部分:
- 门将出生点、墙角夹角:退回空间模型,调整出生点坐标,把门柱与墙之间的夹角改为圆弧或加大间距。
- 进球触发器:退回规则引擎和空间模型,把判定面放在门线上,而不是球网后方。
- 高球出场:退回LLM重新理解意图,给玩家两个选项:加屋顶让球始终在场内,或者补上出界规则和重新开球位置。这个选择会改变玩法,必须由玩家决定。
- 点球阶段:退回空间模型补点球点,再由规则引擎补全点球流程和轮次。
- AI全员追球:退回AI Agent,调整站位权重,让至少一名外场球员保持后场位置。
- 难度过高:交给动态难度模块,先调AI的战术和节奏,而不是直接降低属性。
修改后生成的是V2。每一次修改都应该记录下来,玩家能看到V1和V2之间改了什么,也能退回V1。
Test Again:只重测受影响的部分,然后做一次完整回归
第二轮测试先针对改过的地方:门将出生点连续开局50次,墙角区域让探索型Agent集中撞击,平局场次强制进入点球。确认修复后,再用三类Agent做一次完整的200场回归,防止修改引入新问题。
第二轮测试结果(模拟示例)
出生点、得分、死路和点球阶段四项全部通过。
玩家选择了“补出界规则”,新规则生效后,高球出场会在球出场位置附近的墙边重新发球,测试中未再出现球消失的情况。
AI站位分布改善,但模仿型Agent在新手水平下仍平均净负4球左右,系统建议玩家在发布前查看难度设置,或者开启对新手的战术提示。
这一轮之后,版本才进入可以给玩家试玩的状态。关于生成内容如何在发布前完成完整的验证流程,可以参考AI体育游戏UGC那篇的讨论。
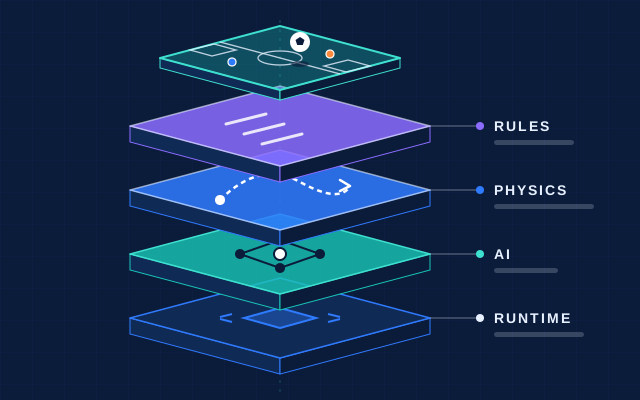
需要说明的是,测试Agent本身不负责计算比赛。球撞墙后怎么反弹由物理引擎决定,进球和犯规由规则引擎判定,整场比赛在Runtime里按帧运行;测试Agent和真人玩家一样,只能通过输入操作、读取公开状态来发现问题。这种分工让测试结果可信:Agent发现“球从墙角穿出去”,指向的是物理碰撞体的问题,而不是Agent自己算错了。
测试Agent现在还判断不了什么
需要把期待放准。公开资料显示,2026年的GBQA基准评测大模型充当QA工程师,表现最好的模型也只找出约48%的已验证bug。TITAN等研究和Razer在GDC 2026推出的自主试玩工具,说明这个方向在推进,但离“替代人工测试”还很远。
在体育游戏里,测试Agent擅长回答“能不能”:能不能进入、能不能得分、能不能结束。它不擅长回答“好不好”:一场6分钟的比赛是不是太短,墙面反弹是否让比赛变得过于混乱,进球庆祝动画是不是太长。这些问题需要玩家试玩后自己判断,测试报告最多能提供参考数据,比如平均每场射门次数、墙面反弹参与进球的比例。
拿到一份自动测试报告,玩家应该先看什么
乐鱼体育的测试报告会把问题按严重程度排序。玩家拿到报告后,可以按这个顺序处理:
- 先看“比赛能否结束”和“得分”两项,这两项不通过的版本不要发布。
- 再看出生点和地图死路,这类问题通常一次修改就能解决。
- 再看规则冲突,涉及玩法选择的,系统会给出选项,由你决定。
- 最后看AI行为和难度,这两项没有绝对的对错,结合你想要的比赛风格调整。
- 每次修改后,确认报告标注的“已重测”范围覆盖了你改过的地方。