被AI读懂和被AI针对,玩家感受到的是两回事
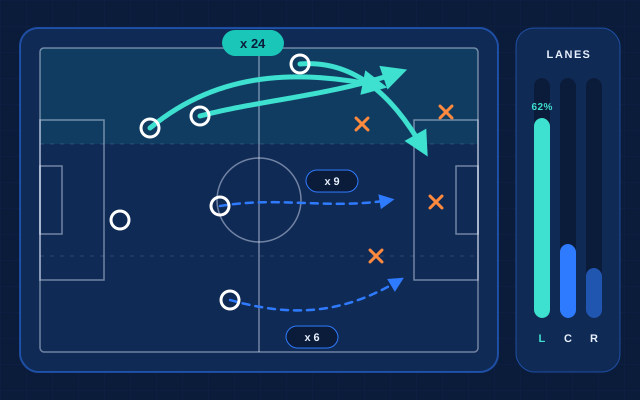
先看一个模拟场景(以下数字均为示例,不是真实用户数据):一名玩家在3v3半场篮球模式里连续打了40场,他最顺手的套路是让2号控卫从弧顶突破,吸引协防后把球分到右侧底角,由3号射手接球投三分。前20场,这个套路的得分效率很高。第25场开始,AI防守者在2号突破时不再全力收缩,而是留一个人贴住右侧底角;到第35场,AI甚至会在他运球过半场时就提前换防。
同样的变化,玩家可能有两种完全相反的感受。一种是“它看穿我了,我得换个打法”,接下来他会尝试左侧挡拆、弧顶急停或者让3号改为空切,比赛反而更有意思。另一种是“它就是在针对我,我怎么打都没用”,这时玩家往往会怀疑系统动了手脚,然后退出。
两种感受的分界线不在于AI学得多不多,而在于三件事:针对是不是通过战术实现的;针对以后有没有留下新的空当;玩家能不能察觉并利用这些空当。下面讨论的就是这三件事在系统里怎么落地。
一个会学习的对手,内部至少分成五层
把“AI学习玩家”当成一个整体黑箱,很容易得出“最后一定会变成克制机器”的结论。拆开以后会发现,每一层都有自己的边界。
| 层 | 记录或产出什么 | 典型内容 |
|---|---|---|
| Behavior | 玩家在比赛里实际做了什么 | 突破方向、传球落点、出手位置、换人时机 |
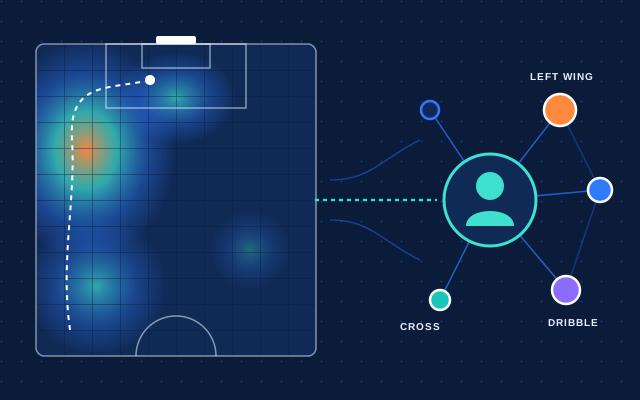
| Player Model | 从行为里归纳出的倾向 | 落后时多数进攻走右侧、领先时喜欢拖节奏 |
| Memory | 这些倾向保留多久、权重如何 | 最近10场权重高,更早的记录逐步衰减 |
| Strategy | 针对倾向选择的对策 | 提前站位、调整协防优先级、改变换防规则 |
| Counter Strategy预算 | 允许对策强到什么程度 | 每场最多针对两个习惯,每个针对必须有代价 |
前四层是大多数讨论都会提到的,第五层常常被忽略。没有预算这一层,系统的优化目标会自然滑向“让玩家的最优套路完全失效”,因为从胜率看,这永远是最划算的选择。一个只追求胜率的学习系统,最后就是专门克制你的对手;这不是AI失控,而是目标写错了。
行业里有可以对照的做法。公开资料显示,Sony AI与Polyphony Digital的GT Sophy在训练中专门设计了奖励函数来约束赛车礼仪,说明AI最终学成什么样,很大程度上取决于系统让它优化什么。Forza系列从2005年起用Drivatar学习玩家驾驶行为来生成对手,思路是把驾驶倾向转化为赛道上对手的行为风格。学习能力本身并不决定对手是否公平,决定因素是目标和约束。
Player Model在几十场比赛里如何保留和衰减,可以参考玩家行为模型那篇的展开,这里只讨论模型产出以后,Strategy层该怎么用它。
AI学战术和AI改数值,在比赛里留下的痕迹完全不同
智能对手最容易出事的地方,是把“决策变好”和“能力变强”混在一起。前者是AI学会了在正确的时间站到正确的位置;后者是AI防守者的横移速度被偷偷提高、抢断成功率被临时上调、投篮命中率在关键时刻上浮。玩家在短期内未必说得出哪里不对,但几十场以后一定能感觉到。
判断一个“克制”是战术学习还是数值作弊,可以看它发生在哪个环节:
| 环节 | 正当的战术学习 | 数值作弊 |
|---|---|---|
| Observation 观察 | 只用球员视野与场上可见信息 | 直接读取玩家手柄输入或下一步指令 |
| Reaction Time 反应时间 | 保持难度档位对应的反应延迟,例如180到250毫秒 | 在玩家按键的同一帧做出反应 |
| Decision Delay 决策延迟 | 预判需要提前站位,站错了要付出代价 | 看清楚再动,也总能来得及 |
| Information Boundary 信息边界 | 只知道“这名玩家过去常走右侧” | 知道“这一次他会走右侧” |
| 属性 | 速度、力量、命中率与卡面一致 | 按比分或玩家胜率临时浮动 |
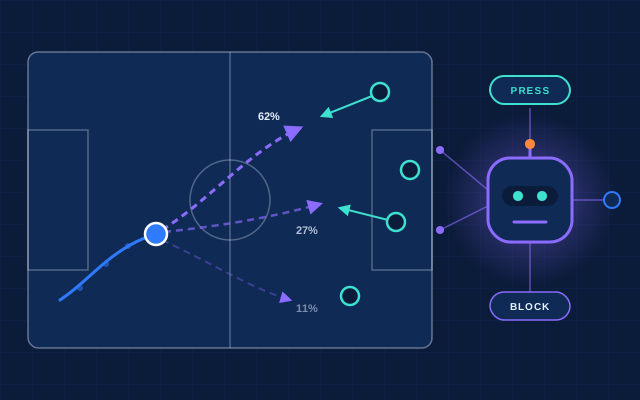
表中的毫秒数只是示例区间。关键在于最后一列的共同点:数值作弊不需要猜,也就没有猜错的可能。战术学习的本质则是下注,AI赌你会走右侧,所以提前把人放在右侧底角;如果你这次改走左侧,它就必须真的漏出左侧。这个“猜错会付出代价”的结构,就是可被反制的来源。
信息边界和反应时间的完整约束,在避免智能对手变成针对玩家的作弊系统一文中有更细的清单。
为什么一个“完全克制”的对手是失败设计
假设技术上可以做到:AI记住了玩家所有的进攻套路,每一个都提前布置好对策。结果不会是一场高水平比赛,而是玩家被迫放弃自己喜欢的打法,转而使用某种AI还没学到的古怪套路,比如反复在中线附近倒脚,等模型更新后再换下一个。
这就是体育游戏里常见的“在对抗AI而不是在打比赛”的状态。玩家的操作越来越不像篮球,AI的对策也越来越不像篮球。
另一个后果是结果不可解释。玩家第30场赢了,第31场用同样的打法输了,他无法判断是自己发挥差,还是AI学到了新东西。复盘时如果看不到原因,他只能把输球归结为“系统在针对”。
所以乐鱼体育在智能对手上的设计思路是:学习玩家的目的是让对抗更像真正的比赛,而不是让玩家的胜率趋近于零。所谓真正的比赛,就是双方都有习惯,都会读对方,也都会被对方读。
让AI留破绽:Counter Strategy预算怎么设
留破绽不是故意放水,而是承认任何对策都有代价,并且不去掩盖这个代价。具体可以落在三个约束上。
第一,每一项针对都必须对应一次真实的防守资源转移。AI决定贴防右侧底角,就意味着协防少一个人,系统不能同时保持原来的协防强度。只要AI没有额外的属性加成去补足空缺,这条约束由比赛模拟本身自然保证。
第二,同一时间被针对的习惯数量有上限。在示例设计中,一场比赛AI最多对玩家的两个高频套路做专门部署,其他套路按通用防守处理。这样玩家总有可用的进攻手段,而且能从“哪两个被封了”读出AI的判断。
第三,针对强度按置信度分级。AI只有在模型足够确定时才提前站位,不确定时只做轻微偏向;偏向幅度也有上限,比如防守重心最多向一侧偏移半个身位,而不是整个人提前站过去。“足够确定”要结合样本量、比分和阵容等情境一起算,不能只看最近几次走位。
流程的倒数第二步最关键:系统要记录玩家有没有发现并利用这个空当。如果玩家连续多场都没利用,说明破绽太隐蔽,或者玩家还没到能读招的阶段,这时应该通过教学提示或复盘说明去帮他,而不是继续加强针对。
可被反制,还要可被看见
破绽存在但玩家看不见,等于不存在。让针对变得可读,有几个成本不高的办法:
- 让调整体现在可见的站位上,而不是隐藏的参数上。玩家从镜头里看到右侧底角多了一个防守人,就能推理出弱侧空了。
- 调整要有节奏。不要在一个回合中途突然切换全部防守规则,而是在暂停、节间或半场之后变化,类似真实比赛里教练的调整时机。
- 复盘里写清楚AI做了什么。例如“第二节起,对手对你的右侧底角三分做了专门盯防,你在左侧挡拆的空间因此变大”,这类说明能把“被针对”转化为“被读懂,然后找到应对”。
- 允许玩家选择对手的学习强度,例如通用对手、会研究你的对手、宿敌模式,让愿意被针对的玩家去挑战,不愿意的玩家不被打扰。
模拟示例:一次被读懂又被打回去的对抗
以下为模拟示例。玩家A在足球5v5模式里习惯让7号边锋沿右路下底传中,过去30场里约六成射门来自右路传中。模型置信度达标后,AI让左后卫站位内收半个身位,同时让一名中场回撤补防右路肋部。
比赛第12分钟,玩家A连续两次传中被解围。第18分钟,他注意到对方中场回撤后弧顶出现空当,于是让10号前插,接7号回传后远射得分。
赛后复盘记录了这一过程:AI针对右路传中做了部署,玩家在6分钟内识别出代价并完成反制。系统据此判断这次针对的强度合适,下一场维持原设置,而不是继续加码。
什么信号说明AI已经“克制过度”
学习系统需要自我监测。以下几个信号在示例设计中用于判断针对是否过头:
- 玩家对同一套路的成功率在几场内从较高水平骤降到接近零,且没有找到替代套路。
- 玩家的比赛行为出现明显的“非体育化”,例如大量无意义的回传、在同一位置反复试探,说明他在对抗系统而不是在比赛。
- 连续几场里,AI的每一次针对都没有被玩家利用,说明破绽不可见或者代价不够。
- 玩家主动切回通用对手,或在比赛中途退出的比例上升。
出现这些信号时,应先减少针对的数量和强度,并在复盘中给出明确说明;而不是转向另一种做法,悄悄降低AI属性来“补偿”。偷偷减属性和偷偷加属性是同一个问题的两面,都会让玩家失去对比赛因果的判断。
留给设计者和玩家的六个检查问题
在乐鱼体育里配置或挑战一个会学习的对手时,可以用下面的问题检查它是否处在健康状态:
- 锁定属性、限制信息以后,AI仍然能做出同样的针对吗?
- 每一次针对,场上能不能看到对应的空当?
- 同一场里被针对的习惯是否不超过两个?
- 复盘能不能说清楚AI针对了什么、玩家是怎么回应的?
- 玩家换了打法以后,AI是逐步跟上,还是在下一回合就立刻识破?
- 玩家能否调低对手的学习强度,或者清除对手关于自己的记忆?
六个问题里只要有两个答案是否定的,这个对手离“专门克制你的机器”就不远了。反过来,如果六个都成立,AI越懂你,比赛就越像两个互相研究过的对手之间的较量。