
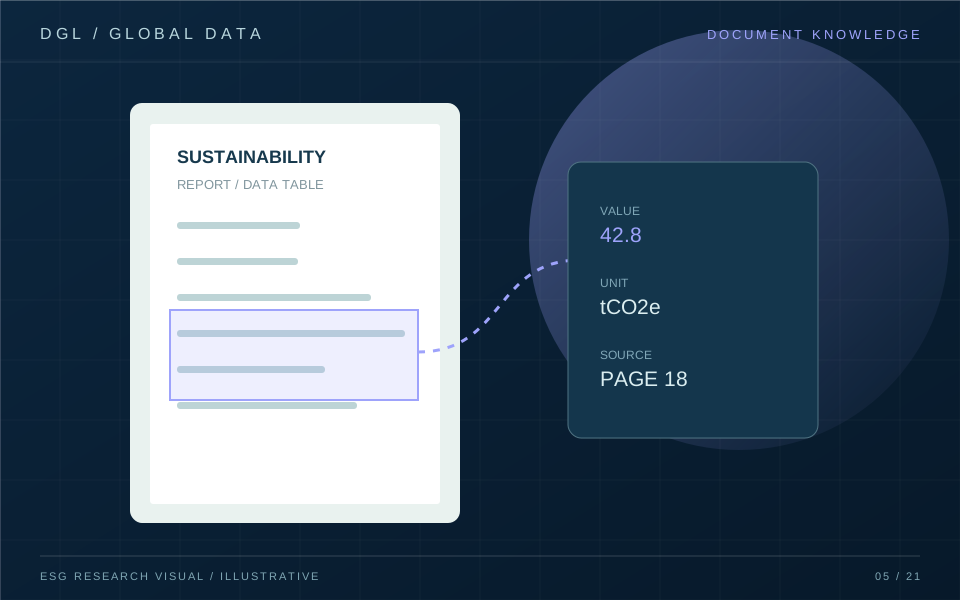
数千份 ESG 报告不缺文字,缺的是可以定位、比较和复核的知识。把 PDF 直接交给聊天模型,可能得到流畅回答,却很难确定数字来自哪一页。这个专题把报告知识库拆成几个必须认真处理的环节。
文档切分不能破坏表格
普通 PDF 解析容易把双栏文字、页眉和表格顺序打乱。处理流程应先识别页面版式,把段落、表格、图注和脚注分别保存,并给每个片段绑定页码与坐标。表格单元格还要保留行列标题与单位。即使之后使用 OCR,也应记录识别置信度,并对重要数值保留原图供审核。
检索要理解企业与年度
知识库检索不能只依赖相似度。用户问“2025 年供应链排放”,系统应先限定企业身份、报告年度、指标类别和报告版本,再在范围内进行语义检索。母公司与子公司、报告年与发布年常被混淆,因此元数据过滤和企业知识图谱与向量检索同样重要。多语言问题还要兼顾原文术语,以免翻译造成指标错配。
回答必须有可点开的出处
RAG 的关键并非把检索片段塞进提示词,而是保证每项事实都能回到报告原文。结果应列出文档标题、页码、表格位置和引用片段;若来源互相矛盾,要说明差异而不是合成一个不存在的数字。对比问题则需要先结构化提取,再在统一口径下运算,避免让语言模型凭文本叙述心算。
建立持续评估机制
可以按数字抽取、跨页表格、脚注理解、跨语言匹配和无答案拒答等场景建立测试集。研究显示,报告 RAG 的表现受检索和模型选择影响,不能只看回答是否通顺。对企业用户更有意义的指标是引用准确率、数值误差、漏报率和人工复核时间。知识库应在新报告发布后增量更新,并保留旧版本以支持回溯。
研究实践:把方法落实到记录
知识库需要特别处理报告中的否定与时间范围。例如‘尚未设立净零目标’不能被检索器误当作‘已设立目标’,而‘2023 年目标’也不能用于回答 2025 年实际排放。对于跨报告比较,系统先抽出带单位和边界的结构化记录,再执行计算,最后让模型解释差异;这比要求模型直接在长文本中推算稳健得多。
进一步观察
以提问“某公司是否披露了水压力区域的用水量”为例,关键词检索可能只找到企业总取水量,而真正答案藏在附录的地区表格。系统应先识别问题中的实体、地区和指标,再在对应报告版本里检索。若没有地区拆分,就清楚说明“找到总量,但未找到水压力地区明细”;不能拿总量代替问题所问的数据。
知识库的更新也有成本。企业发布更正报告后,旧文档的向量索引和已抽取指标都可能过期。应建立文档级与指标级失效机制,重新运行受影响的检索评估。研究人员可以把常见错误回写为标注样本,例如跨页表格断裂、脚注归错行和不同语言的单位误译。持续迭代的关键不是让模型记住答案,而是让证据管道越来越可靠。
研究建议
回答界面还应区分直接引用与模型推论。直接引用是报告明示的事实,推论可能结合多个来源与计算。若用户询问‘为什么排放上升’,模型不能把报告中提到的扩产自动认定为唯一原因;应同时展示产量、收购、边界重述等可能因素,并说明哪些有原文支持。
对知识库而言,拒答是重要能力。用户问及报告没有披露的事实,系统应说明检索了哪些年度和文件,并建议进一步查看监管公告或企业说明,而不是把相邻指标拼成答案。
本文为基于公开资料的方法研究,不构成投资、法律或具体企业评级意见。引用标准与监管动态请以原发布机构的最新文本为准。