
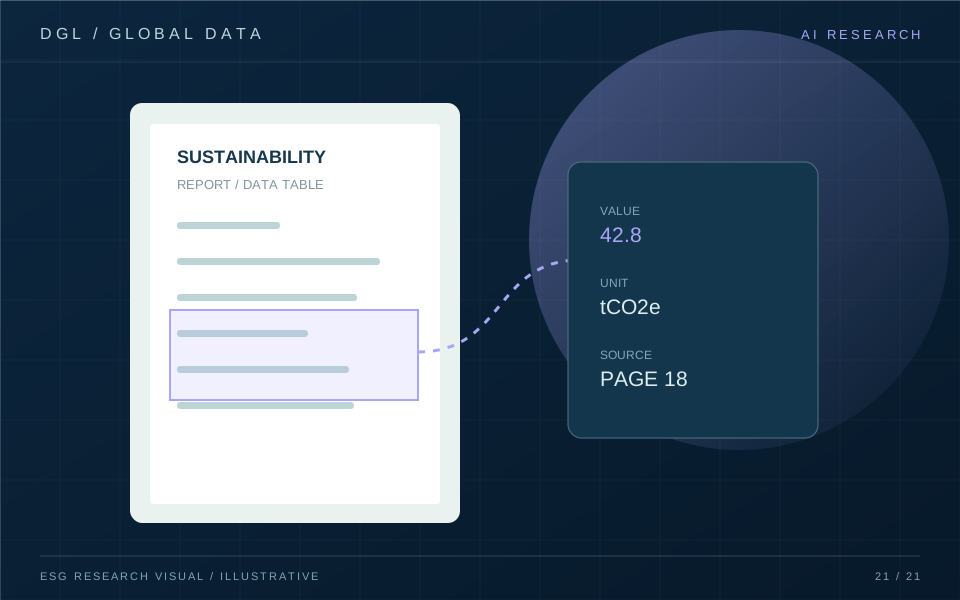
AI 在 ESG 数据研究中的价值正在从“快速总结报告”转向“从复杂文档中抽取可核验事实”。2026 年公开研究继续讨论 RAG、表格理解和评分预测,同时提醒模型输出需要经过真实报告评估。对于风险监测,新闻事件与企业关系的准确匹配仍是重要瓶颈。
报告分析走向结构化
ESG 报告包含正文、跨页表格、图表与脚注。2026 年的 ESGLens 研究提出按文本、表格和图表类型处理报告片段,并结合 GRI 指标抽取与评分预测。这类方法表明,简单把整份 PDF 送入通用聊天界面,很难支持严格的指标比较。研究系统需要把文档解析、标准映射与证据定位作为独立环节,并能让用户打开原页核对。
RAG 的效果需要实证检验
2026 年 9 月一项针对 ESG 领域检索增强生成的研究,使用数百份真实企业报告构建评估资源。其意义在于把模型比较放进实际报告场景,而不是只展示几个成功回答。另有 2025 年末研究指出,模型的置信分数未必与正确性良好校准。对企业使用者来说,引用准确率、数值误差、无答案时能否拒答,比回答语气更重要。
评分预测不能跳过方法论
研究模型可以利用抽取的 ESG 片段估计外部评分,但预测得像某一家机构,并不代表找到普遍正确的 ESG 表现。评分数据自身受行业权重、披露覆盖率和评价目的影响。若训练集主要来自特定地区的大型上市公司,模型迁移到其他市场时可能产生偏差。系统应公开数据分布、误差、指标权重和人工审核机制,而不是只给出一个貌似客观的总分。
新闻事件是另一种技术问题
企业事故、劳动争议和治理处罚常先出现在多语言新闻与监管公告中。AI 可以完成事件分类、翻译和候选实体识别,却必须处理同名企业、母子公司关系和重复转载。没有证据分级,模型可能把调查消息当成最终处罚;没有关系图,又可能把供应商事件错误归给采购方。文档 AI 与事件 AI 应共享主体库,但分别维护证据状态。
从自动化转向可审计工作流
较稳健的路线是让模型负责发现候选、整理片段和提示异常,让规则与分析员共同确认关键数值和重大事件。输出中记录报告版本、页码、来源网址、模型版本和复核时间。这样的系统未必总是最快,却能在标准变化或企业更正披露后解释旧结论为何不同。AI ESG 研究的下一步,更像一套可审计的数据工程,而不是单独的聊天窗口。
研究实践:把方法落实到记录
研究者可以设计一组跨领域验证题:让系统找出某企业报告中的排放表格,再核对新闻中相关设施是否属于该企业,并标注监管事件状态。这一测试同时检验文档解析、主体识别和证据融合,能暴露单模块演示不容易发现的错误。模型可提供候选,最终公开结论仍需要人审核。
本文为基于公开资料的方法研究,不构成投资、法律或具体企业评级意见。引用标准与监管动态请以原发布机构的最新文本为准。